
1 はじめに
我々は、ソフトウェアを監査するためのプログラム解析の開発と、人がソフトウェアを監査するのを助ける解析の設計に焦点を当てている。1 では、なぜ人と機械の協働に焦点を当てるのか。[8] において Brooks は、「利用できるシステム技術のどの水準においても、知能増幅システムは [人工知能] システムに勝ちうる。すなわち、機械と人の心の組み合わせは、単独で動作する人の心を模倣する機械に勝ちうる」という命題を提唱している。知能の増幅は、自動化だけではスケールしない難しい問題、特に大規模なソフトウェアの問題を解くうえで特に重要である。
1 この文脈において、監査には、数百万行のコードベースにおける重要な安全性とセキュリティの性質の体系的な検証が含まれる。
1.1 人に優しいプログラム解析の問題
多くのプログラム解析では、明確に定義された性質を対象とするものであっても、プログラムの振る舞いが機能なのか欠陥なのかを判断する過程に人を関与させる必要がある。
監査システムには、機械と人という二つの主要な構成要素がある。これらの構成要素はどちらも動作するのに時間を要するが、両者の協働にも時間が費やされる。多くの研究は、プログラム解析の精度とスケーラビリティに焦点を当てている [21, 23, 2, 24, 13]。ソフトウェアの監査の過程を、依存関係と起こりうるプログラムの状態からなる迷路を走り抜けることにたとえるなら、これらの研究は迷路の大きさを小さくしようとするものと特徴づけられる。これは重要な研究目標である。しかし、現在の技術水準では、機械が単独で出口を見つけることはない。人に必要な役割を考えると、それは重要な分岐点でどちらに曲がるかを決める手助けである。監査の過程を効率的にするためには、機械は、人が次の重要な判断を下すのに役立つ形で解析の現状を表現しなければならない。そうすることで、機械は人が迷路を走り抜けるのを助け続けられる。
したがって、プログラム解析は有用な次の一歩を提供すべきであり、それ自体が目的であるべきではないという前提のもとで取り組む。
このホワイトペーパーでは、次の研究課題を探る。ソフトウェアの監査において人と機械の協働を支えるシステムの主要な特徴は何か。数百万行のプログラムにおける困難な検証問題に取り組むための人と機械の協働を可能にするよう設計された代表的なシステムとして、XCSG を示す。
2 動機と背景
2.1 なぜグラフか
グラフはシステムの中心的な特徴であると我々は考えている。その理由の一つは、グラフが数学において性質を証明するのに有用な構造として長い歴史を持つことである。グラフは何十年もの間コンパイラで使われてきた。Allen [6] は、プログラムの最適化に用いるためにグラフを導入した。
しかし、グラフは何を表現すべきか。単一のプログラム解析であれば、必要な意味論と表現を規定できる。人の場合、何が必要になるかを前もって知るのは難しい。幸い、プログラム全体の表現をグラフデータベースに入れることは扱える規模になっており、ソフトウェアの検索と解析を助けるためにグラフデータベースを用いることへの関心が高まっている [27, 15, 33, 18]。重要な問いは、もはや抽象構文木(AST)全体とプログラム解析をデータベースに入れられるかどうかではなく、人と機械の協働を促すためにそれらの抽象をどのように構造化すべきかである。
弱い形の協働は、人が単にグラフを読んで解釈することを期待するものである。しかし、グラフはそれ自体が目的であるべきではない。中間結果はグラフとして表現されうるが、そのグラフは人との対話とさらなる自動解析を促すべきである。要するに、人と機械の協働を途切れさせないようにすべきである。理想的には、解析は人が最も重要な問いに集中し続けられるよう設計されるだけでなく、特定の問いへの答えを解決することを目指したさらなる解析によって人の手の届く範囲を広げるべきである。この協働の形は、より複雑な、あるいはより細かい解析の扱いやすさの問題を克服し、中間的な解析結果をより簡潔に保つのに役立つ。
多くの解析結果をグラフデータベースに取り込めるが、可能なすべての解析をデータベースに入れることはできない。自明な例は、停止しないプログラムからの無限のトレースである。さらに、現在では、それぞれ数百万行のコードからなるソフトウェアシステムが数多くある。そのため、スケールできる解析と表現にまず焦点を当てるという設計上の制約も加わる。さらに、特に解析の作成と組み合わせに影響し、機械と人の協働に影響するので、それらがグラフ表現の中でどのように融合されるかを考えることが重要である。
2.2 プログラム解析におけるグラフ
先に述べたように、グラフは数学において性質を証明するのに有用な構造として長い歴史を持ち、プログラムの最適化に関する Allen の研究 [6] にさかのぼって、長くコンパイラで使われてきた。
プログラム依存グラフ(PDG)[10] は制御フローとデータフローを統合し、システム依存グラフ(SDG)[17] はそれを手続き間の解析に拡張した。より最近では、PDG はオブジェクト指向言語、特に Java Virtual Machine のバイトコード向けに適応されている [14]。これらのスケーラブルなグラフ表現は、一部は最適化コンパイラのため、すなわち人の意図を機械に明確に伝えるために作られた。我々の目標の一つは人との協働を可能にすること、すなわち一部には、機械向けの伝達を人に向けて明確にすることである。PDG に関する初期の研究には、ソフトウェア開発環境での使用、特にスライシング [30, 31] への適性についての考察が含まれている [22]。しかし、[28] において Waters は、自動化と人の推論の両方を助ける解析について、特に説得力のある議論を行っている。
2.3 局所性
Waters は、プラン構築法(PBM)に基づいてループを解析する方法を示している。PBM は、ループの理解を容易にし、正しさの証明を導く方法として示されている [28]。その論拠として、Waters は配列の要素を合計する for ループの例を用いる。テキストベースの表現では、結果を累積するのに使う変数の初期化は、一部にはループ制御の文のために、累積を行う文から必然的に離れてしまう。Waters はさらに、密接な関係を持つ二つの要素を離すとループの効果を理解しにくくなると論じている。
これらの問題に照らすと、グラフにはもう一つの明らかな利点がある。字句上は離れていても、関連する実体を隣り合わせに表示するのに役立つことである。
2.4 解析の融合
グラフは、さまざまな解析を組み合わせるための共通の基盤の役割を果たす。先に述べたように、[27] は、構造、意味(識別子の束縛の解決など)、制御フロー、データフロー、実行時の情報といった複数の解析を単一のグラフデータベースに組み合わせられるという考えを提唱している。その根拠の一つは、多くのクエリは表現するのに複数の解析からの情報を必要とする可能性が高いということである。
我々は、一貫した形で解析を融合するグラフ表現を目指す。統一的な表現は、困難な問題に対する創造的な解決策を生み出すのに役立つ。さらに、自動化と人と機械の協働の両方のために、互いに組み合わせられる解析を求める。
3 XCSG:プログラムと関連する解析の、人に優しいグラフベースの表現
3.1 設計の推進要因 – XCSG とは何か
まず背景として、XCSG の開発に用いるプラットフォームは、プログラムのテキストベースの形式をグラフベースのビューと並べて表示する機能を備えている。両者は連動しており、テキストをクリックするとグラフ内のノードやエッジに対応付けられ、その逆も同様である。このプラットフォームでは、どちらのビューでの選択にも応答し、我々が計算するグラフ(変数のクリックに応じたデータフローグラフなど)によって応答するプラグインを作成できる。これにより人と機械の協働が可能になる。基本的なユーザーインターフェースの要素は図 1 に示す。
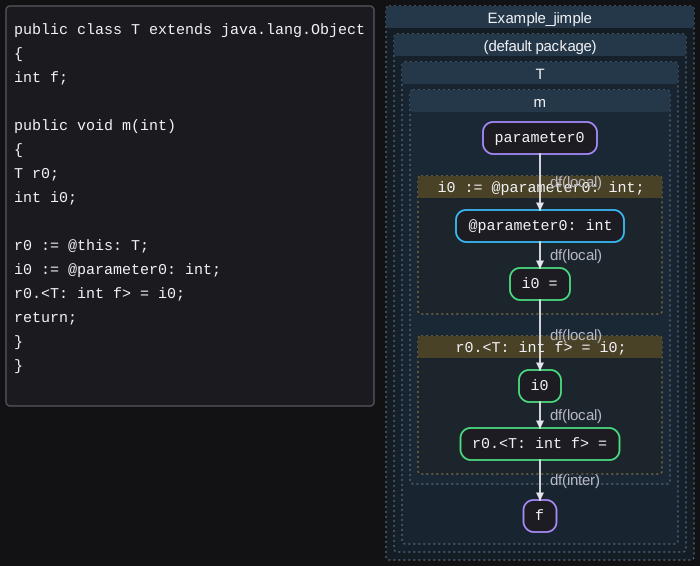
対話を容易にするために、表現はよく使われる関係をたどりやすくし、テキスト形式への対応を提供すべきである。これは、グラフにソースとの対応を注釈することで実現され、それにより上述のテキストとグラフの対応が可能になる。解析を可能にするために、XCSG はプログラム全体を表現しなければならない。これは抽象構文木(AST)を取り込むことで実現できるが、我々の目的にとって、それは必要ではあっても十分とは言いがたい。これは重大な設計上の問題であり、本節の残りでその説明を行う。
ノードとエッジの種類をモデル化するのに用いる同値類は、最終的に表現の有用性と簡潔さに影響する。一般に、我々の設計上の選択は、主要な実体と関係をどのようにモデル化するか、そしてそれらの同値類をどうするかを決めることに帰着する。これはノードをどのようにまとめるかを決める場合にも当てはまるが、グラフの推移的な走査に影響するので、エッジについても同様である。
XCSG との対話の多くは、第 4 節で説明するクエリ言語を通じて行われる。ここでは、それがエッジの部分集合上の走査を指定する方法を提供することを知っていれば十分である。ただし、他のグラフクエリ言語 [3, 32] に見られる高度なパターンマッチングは意図的に提供していない(ただし、複数の種類を持つエッジはサポートしている。これについては後述する)。クエリ言語を最小限にしたことで、ノードとエッジの同値類を慎重に選ぶ必要に迫られた。そうでなければ、AST をそのまま書き写していたかもしれない。この過程の結果、より使いやすいモデルが得られる。
3.2 Jimple のための XCSG
XCSG の設計目標には、解析の追加の層を XCSG のグラフに組み込めるようにすること(eXtensible にすること)と、複数のプログラミング言語の意味論に一貫した表現を提供すること(Common なソフトウェアグラフにすること)が含まれる。ただし本節の残りでは、主として XCSG が Java バイトコードの中間表現である Jimple [4] をどのように表現するか、そしてその表現の背後にある設計上の考慮事項に焦点を当てる。XCSG はプログラム全体の意味論を捉えており、XCSG から Jimple へ逆に変換するのに十分な情報がある。2
2 Jimple 自体が、解析と理解を容易にするという点で、すでに Java バイトコードから一歩進んだものである。Java バイトコードには 200 を超える演算があるのに対し、Jimple の演算は 20 未満である [4]。さらに、Jimple はスタックベースのバイトコードから三番地コードに変換されており、読みやすい。
本節の焦点は、設計の主要な側面、すなわちノードの同値類、そして特にエッジの同値類を説明することである。
XCSG が記述するグラフは有向である。実際には、基盤となるグラフデータベースはどちらの方向の走査もサポートすることが期待される。ノードとエッジは属性を持つことがあり、通常は表示のための名前と、プログラムのテキストベースの形式と対話するためのソースとの対応を持つ。ノードとエッジは種類(kind)を持つことがある。これは、XCSG で表現される言語の型との曖昧さを避けるために用いる用語である。実際には、種類は定数の文字列によって実装される。しかし、XCSG は種類どうしの関係を記述する。たとえば、静的メソッドは種類 ClassMethod を持ち、これは Method の一種である。実際には、これはユーザーがより広い、あるいはより狭い同値類でクエリを行うのに役立つ。たとえば、種類 Type に対するクエリには、Java.Class、Java.Interface、Java.Enum、Primitive が暗黙に含まれる。
現時点で、XCSG が扱う解析は、宣言的な構造、呼び出し、制御フロー、データフローに大別できる。ノードの同値類は比較的簡単に説明できるが、エッジの同値類は興味深い設計上の問題であることが分かった。視覚的な表現における局所性の実現は、関連するノードの間にエッジを作ることで助けられるが、走査はエッジの方向の選択とエッジの同値類の影響を受ける。
本節の残りは、ノードによってではなく、エッジが関係をモデル化するためにどのように使われるかによって構成する。これが XCSG を理解する鍵だからである。網羅的であることを意図したものではないが、この説明は第 5 節で示す解析の例を理解するのに十分であることを意図している。XCSG の追加の文書は [5] で公開されている。
3.3 すべてはつながっている
ノードは主として、Contains エッジを用いて字句上の入れ子に従って整理され、その部分グラフは木を成す。これには二つの目的がある。第一に、可視化したとき、Contains エッジはノードの中に入れ子になったノードとして表示される。これは、特に Contains 階層の下のほうにあるノードについて、その位置の文脈を与えるのに役立つことが分かっている。第二に、用途に応じて、与えられたパッケージ、型、またはメソッドの下にあるすべてを推移的に含むクエリを書く便利な方法を提供する。これはデータフローにまで及んでおり、この事実は後に第 5 節の事例研究で活用する。
プログラムの宣言的な構造は、型やメソッドといった実体を扱う。また、Project や Library といったコンテナも含む。これらは必ずしもプログラムの一部ではないが、その下の宣言を選択するのに実際に役立っている。
Contains エッジに沿ってメソッドのパラメータまで下る典型的なパスは、図 1 に見られるように、XCSG の種類 Project、Package、Type、Method、Parameter を持つノードを通る。最も外側のノードは Project であり、残りは階層に従って入れ子になっている。図には DataFlow_Edges を通るパスも示されている。このパスは左の Parameter から始まり、ControlFlow_Nodes(黄色)の中に入れ子になった DataFlow_Nodes を通り、右の Field で終わる。宣言的な実体のノードの名前は単純名である。完全修飾名は Contains 階層によって暗に示されるからである。
3.4 過剰な接続を避ける
Supertype と Overrides の関係は、それぞれ Types の間と Methods の間にモデル化される。型付けの関係は、推移閉包ではなく、型どうしの直接の関係に基づいてモデル化される。[27] は、多くのクエリ言語が推移閉包をサポートしていることを根拠に同様の表現を主張したが、我々がそうするのは、型付けの関係の推移閉包をすべて含む型階層を表示すると扱いにくくなるからである。やや関連する話として、XCSG は現在、Methods を、それを継承する Types に複製するのではなく、宣言された場所にモデル化している。
3.5 エッジを一貫して使う
Parameters と Fields は Variables の一種であり、宣言された型を参照するための TypeOf エッジを持つ。同様に、DataFlow_Nodes も TypeOf エッジを持つ。これらは強く型付けされた式と局所変数を表すからである。この場合、モデルの異なる層にまたがっても同じエッジを持つことは有用である。Variables と DataFlow_Nodes は、データフローモデルの一部として DataFlow_Edges によってもつながっているからである。
XCSG では、TypeOf エッジは宣言を表す Type を指す。型は文字列の属性として表現することもできたが、可能な限りエッジを用いている。これにより二つの目標が達成される。第一に、複雑な文字列のエンコーディングではなく、ノードを用いて同一性を表すことを促す。第二に、属性値によってではなく走査によって実体にアクセスする形に統一される。あるノードの属性の値を使って別のノードを見つけることは、クエリとして書くのがより厄介である。始点のノードの属性キーと、(おそらく)異なる終点のノードの属性キーの両方を覚えておく必要があるからである。エッジを使えば、エッジの種類とその方向を覚えておくだけでよい。
3.6 エッジを使って要約する
コールグラフは、プログラムを理解する際に最もよく使われる道具の一つである。呼び出しの関係は、単一のメソッド内にある潜在的に多数の呼び出しの実例を要約する有用なものである。
オブジェクト指向言語では、呼び出しは動的ディスパッチによって解決されることがある。静的解析から見ると、呼び出しは多数の可能な呼び出し先に解決されうる。粗い水準では、呼び出しの文脈から呼び出し先のメソッドへのこれらの可能な呼び出しは、コールグラフに要約される。XCSG では、これらは Methods の間の Call エッジによって表現される。
XCSG の Call エッジは、精度の異なる多くの解析に基づいて作成できる [9, 21]。3.8.3 では、XCSG が呼び出し箇所をどのように表現するかを説明する。これはそのような解析を可能にするのに使える。
3.7 種類をうまく選ぶ
XCSG は種類どうしの関係を記述し、これはエッジにも適用できる。これにより、エッジの同値類をモデル化でき、それが推移性に影響する。
たとえば、Supertype の種類は、Java のキーワードに対応する下位の種類 Extends と Implements を持つ。Extends の種類を用いた走査は、Java.Class から Java.Interface への移行のところで途切れてしまう。Supertype の種類を用いて両方の下位の種類を走査すれば、関連するすべての型に到達する。
エッジの同値類の選択は、データフローと制御フローのモデルにおいて特に重要である。これらが新しい解析を組み立てる基礎となるからである。
先に述べたように、データフローモデルは、フローを示すために DataFlow_Edges を用いて Variables と DataFlow_Nodes をつなぐ。種類 DataFlow_Edge は、局所的なフローと、メソッドの呼び出しやヒープへのアクセスを伴うフローを区別するために、下位の種類 LocalDataFlow と InterproceduralDataFlow を持つ。実際には、データフロー解析を利用するクライアントの解析は、両方を走査するために DataFlow_Edge の種類を用いる。しかし、可能なフローを作成または精緻化するデータフロー解析は、これらの種類が示す意味論を活用できる。JVM バイトコードにはスタックを指すポインタがないので、局所的なフローは手続き間の解析なしにフロー感応的に計算できる。InterproceduralDataFlow エッジは、ポインタ解析が感度に応じて作成する場合もしない場合もあるフローに対応する。ポインタ解析は今なお活発な研究領域である [23, 7, 13, 2, 24]。
次の節では、推移性の例外、すなわち命令の重要な役割を表現するのに必要なエッジの種類と、それらがデータフローとどのように関係するかを論じる。
3.8 解析を可能にする
表現の豊かさという点では、データフローモデルが群を抜いている。本節の残りでは、主として、データフローモデルが命令の意味論をどのように捉え、それによって他の解析を XCSG に基づいて記述できるようにしているかを論じる。
3.8.1 演算子と代入
データフローの表現は多くの下位の種類を持ち、それらはおおむね Jimple に見られるさまざまな命令に対応している。
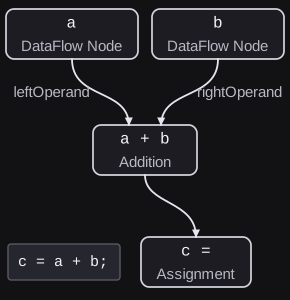
データフローの表現は、演算子に関して細粒度である。オペランドは DataFlow_Edges によって Operator につながり、これにより分かりやすい可視化が得られる。それを抽象化した形で図 2 に示す。図では、すべてのエッジが種類 DataFlow_Edge であるが、左右を区別するための追加のタグを持つ。演算の意味論は、DataFlow_Node の特定の下位の種類、この場合は Addition によって捉えられる。最後に、結果は別の下位の種類である Assignment へ流れる。同値類は、共通の親の種類に基づいてクエリが通り抜けられるようにしつつ、細粒度の解析が同じ表現を基礎として使えるだけの詳細を保つよう、慎重に選ばれている。Assignments は Operators とは区別される。これらは基盤となるビットの変換を表さないからである。
Instantiations は新しいインスタンスへの参照を表し、通常はすぐにクラスの初期化子に渡される。
3.8.2 層の融合
データフローの表現のもう一つの興味深い特徴は、値が条件に影響を与えるために使われることを表す DataFlowCondition ノードの使用である。データフローの層に焦点を当てた可視化では、
DataFlowCondition で終わるフローは、現在のフローが情報フローにつながりうるという人への合図となる。DataFlowCondition ノードは ControlFlowCondition のすぐ下にあるので、プログラムによって一方から他方へたどり、制御フローグラフにおける後続を取得できる。
バイトコードでは、同期は、オブジェクトをロックおよびアンロックする命令、それぞれ enter monitor と exit monitor と呼ばれる命令を用いて実装される。XCSG では、モニタは、同様の理由から、DataFlowConditions とほぼ同じように別個の DataFlow_Nodes でモデル化される。
3.8.3 配列とフィールドへのアクセス、呼び出し箇所、インスタンス化
ここで論じる残りのデータフローの下位の種類は、より複雑で興味深いものの一部である。ポインタ解析に関心のある解析の開発者にとっては、特に関連が深いはずである。これらは Operators に類似しているが、一般にオペランドのエッジに固有の種類を持つ点で区別される。これらのオペランドの種類は DataFlow_Edge の下位の種類ではない。直接のデータフローに対するクエリが、すべてのデータ依存関係へ自動的にあふれ出るのを防ぐためである。
配列とフィールドへのアクセス 配列へのアクセスは、図 3 に見られるように、右辺値の文脈でも左辺値の文脈でも同様に、それぞれ ArrayRead または ArrayWrite の種類を用いてモデル化される。ArrayRead は名前付きのオペランドを二つ持ち、一つは配列の参照、もう一つは添字の式である。これらの名前付きのオペランドの種類は DataFlow_Edges ではないので、破線で示されている。
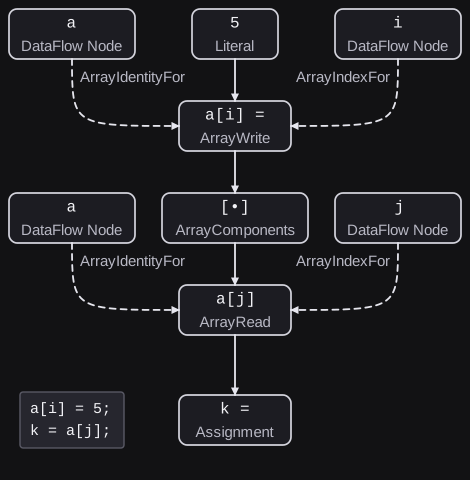
DataFlow_Edges は、ヒープ上の抽象オブジェクトを表す ArrayComponents ノードを通って流れる。
インスタンスフィールドへのアクセスも同様であり、アクセスのノードは親の種類 InstanceVariableAccess を持つ。ただし、フローは ArrayComponents ノードではなく Field ノードにつながる。これらのエッジをさらに限定しなければ、単純な走査は、フィールド感応だがヒープ非感応のデータフロー解析に相当する。ArrayComponents ノードが Field と異なるのは、フローを保守的に表現するには、すべての配列へのアクセスに対して単一の ArrayComponents ノードが必要になる点である。main メソッドが与えられれば、ポインタ解析は抽象オブジェクトに対応する ArrayComponents ノードを生成し、InterproceduralDataFlow エッジによって ArrayAccess ノードにつなぐ。
インスタンスフィールドはさらに基底オブジェクトのオペランドを必要とするので、Operator と類似の役割を果たすために、InstanceVariableAccess と呼ばれる追加のノードがフローの間に挿入される。表現は、アクセスが右辺値か左辺値かによってわずかに異なり、前者は下位の種類 InstanceVariableRead、後者は InstanceVariableWritten を持つ。静的フィールドへの出入りのフローは Field に直接つながる。親の Type は、両者の間の Contains エッジによって暗に示されるからである。
人のためのアフォーダンスという点では、この表現はアクセスのノードにソースとの対応を持つ。これは、テキストエディタでの選択が、フィールドの識別子と、そのフィールドがアクセスされた制御フロー上の地点の両方に対応することを意味し、対話的な解析で活用できる。
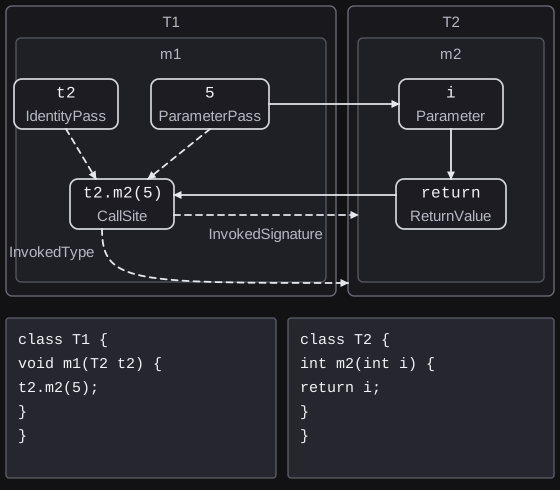
呼び出し箇所と配列のインスタンス化 呼び出し箇所は、任意の数のパラメータと、インスタンスメソッドの場合には対象のオブジェクトとの組み合わせを表すので、おそらく最も高度なモデルの一つである。図 4 に CallSite のモデルを示す。XCSG では、CallSite は、Operator と同様に、メソッドを呼び出して返される値を表す DataFlow_Node である。void の場合でも、ノードは発生する事象のプレースホルダとして存在する。CallSites は、静的ディスパッチと動的ディスパッチを区別するために、ディスパッチの方式に対応する下位の種類を持つ。静的ディスパッチを表す CallSites は InvokedFunction エッジによって、動的ディスパッチを表すものは InvokedSignature エッジによって、代表となる Method ノードにつながる。CallSite への実引数は、種類 ParameterPass(およびインスタンスメソッドのレシーバに対応する IdentityPass)を持ち、種類 ParameterPassedTo と IdentityPassedTo のエッジによって CallSite につながる。これらのエッジは、各引数の添字を示す属性を持つ。潜在的な呼び出し先の解析は、実引数を仮引数に InterproceduralDataFlow エッジでつなぐことで、呼び出されるメソッドへのフローを表現でき、同様に、呼び出される可能性のあるメソッドの Return ノードから CallSite ノードへ戻るフローも表現できる。
ArrayInstantiation のモデルは CallSite にやや似ているが、メソッドへのエッジを持たず、各次元の長さを定める式に対応する任意の数のエッジをサポートする。このノードはヒープへの参照を表す。配列以外の型の Instantiation も同様であるが、追加のエッジを必要としない。
3.8.4 配列のインスタンス化
最後に、配列の割り当ては ArrayInstantiation ノードを用いてモデル化される。一次元の配列も多次元の配列も同じ表現にまとめられる。ArrayInstantiation は CallSite にやや似ているが、メソッドへのエッジを持たず、各次元の長さを定める式に対応する任意の数のエッジを持つ。ノード自体は抽象ヒープオブジェクトへの参照を表し、それは最終的に ArrayAccess の配列参照のエッジへ流れる。
次の節では、対話的な表示のために部分グラフを選択するのに用いるクエリ言語について詳しく述べる。
4 対話的なクエリ
前の節では、XCSG がプログラム全体と特定の一般的なプログラム解析をどのように表現するかを説明した。XCSG はそれ自体で成り立つものであるが、その背後にある設計上の選択に影響を与えた要因の一部は、XCSG と対話するのに最もよく使われるクエリ言語にさかのぼることができる。
4.1 設計上の考慮事項
クエリ言語は Java の埋め込みドメイン固有言語(DSL)として実装され、[11, 12] に着想を得たビルダーパターンに従う。DSL にする理由は、グラフから何を選択するかを表現するための抽象の層を加え、表現をある程度簡潔にし、クエリの最適化を可能にする間接の層を残すことである。埋め込みにする理由は、Java のような命令型言語にすでにある有用な機能を作り直さずに済むことである。
このクエリ言語は、通常、Java のインターフェースの単純名である Q と略式に呼ばれる。3 Q はグラフから何を選択するかを記述するのに使われ、その式は部分グラフを生み出す。ビルダーパターンにより、インターフェース Q のほぼすべてのメソッドは型 Q の式を返し、メソッド呼び出しを連鎖させることで実質的にクエリの AST が指定される。Q の式の連鎖は eval() メソッドを呼び出すことで評価でき、これにより命令型の実装に適したグラフ API に移行する。Q のメソッドは、返される部分グラフが正しいグラフであること、すなわちエッジが存在するのは接続するノードも存在するとき、かつそのときに限ることを保証する責任を負う。Q から見ると、グラフデータベース全体は universe() と呼ばれる式である。したがって、クエリの結果は universe の部分グラフを返すことに限られる。
3 1 文字の名前は、Java でクエリを書くのに必要なキー入力の回数を減らすために選ばれた。
Q の設計の背後にある主要な用途は、解析の設計者が、グラフの関連する部分を選択する 1 行のクエリを素早く書けるようにすることである。要するに、現在の位置から「角の向こうを見回し」、関連してはいるが字句上は離れたプログラムの要素をまとめられるようにすることである。他の多くのグラフクエリ言語 [3, 32] とは異なり、Q は各段階ですべての一致を意図的に和集合にする。たとえば、複数の Method ノードを起点として与えると、コールグラフのクエリは、パターンへの個々の一致を返すのではなく、単一の統合されたグラフを返す。
Q の設計で最初に考慮したことの一つは、グラフの走査、特にコールグラフを比較的簡単に表現できるようにすることであった。Q の意味論を、例を用いて段階的に紹介する。
まず、種類は XCSG インターフェースの文字列定数を用いて表されることに注意する。たとえば、XCSG.Method は Method の種類を表す文字列定数である。XCSG の種類に対するクエリは、下位の種類もすべて結果に含まれるよう、基盤となるグラフデータベースによって暗黙に処理される。さらに、基盤となるグラフデータベースは、性能を高めるために、グラフの要素をその種類と属性値で索引付けしている。本節の残りでは、表現を簡潔にするために、文字列定数は static import されているものとする。
Q では、式 universe().nodesTaggedWithAny(Method) は、すべての Methods からなりエッジを持たない部分グラフを選択する。これは、ビルダー記法を用いてクエリをどのように連鎖させるかを示している。ここで universe() はグラフデータベース全体であり、nodesTaggedWithAny は左側の式から一致するノードを選択する。
より興味深い例は順方向のコールグラフであり、edges(Call).forward(x) と表現できる。ここで x は起点となる Methods に対する前のクエリである。しかし、この式は多くの振る舞いを隠しており、それが何をするかを完全に説明するには、それを解きほぐさなければならない。
まず、edges(Call) は、universe().edgesTaggedWithAny(Call) と等価な、static import された便利なメソッドである。このクエリ edgesTaggedWithAny(Call) は、種類 Call のエッジを選択する。4 ただし、微妙な点として、この選択の過程は左側の式のすべてのノードを保持する。その結果、クエリ edgesTaggedWithAny は universe のすべてのノードを保持する。これは設計によるものである。与えられたメソッドからコールグラフを構築しようとするとき、たとえつながっていなくても、通常はそのメソッドが結果に含まれることを期待する。実装されたとおり、これは期待どおりに動作する。もしエッジの選択が、まず接続性によってノードを絞り込むように実装されていて、そのメソッドがたまたま Call エッジでつながっていなければ、空のコールグラフという直観に反する結果になってしまう。
4 Tags は、実装において XCSG の種類がエンコードされる方法である。我々はこれらの用語を同じ意味で用いる。
ビルダー記法の合成から、設計のもう一つの点が浮かび上がる。入力(式の左側のグラフ)は、universe の任意の部分グラフでよい。Q は Java に埋め込まれているので、必ずしも Q を用いて書かれていない命令型のスタイルで書かれたアルゴリズムと組み合わせられる。我々が用いる実装には、ノードとエッジに直接アクセスできる、グラフのデータ構造を中心とした低水準の API がある。この低水準のグラフ API は、支配ノード、強連結成分、推移閉包などを計算するアルゴリズムを書くのに使われてきた。これらのアルゴリズムは必要に応じて Q と交互に使え、1 行から始まるクエリから高度なプログラム解析へと発展させる道筋を提供する。
4.2 クエリの式と用途
Q のクエリの式はインターフェースのメソッドに対応し、1) タグまたは属性による選択、2) 集合に基づく式、3) 走査、を提供するものにおおむね分類できる。
各分類の概要を簡単に示し、特殊な側面と典型的な用途を指摘する。
4.2.1 選択の式
選択の式は、他のクエリのためにノードとエッジを一致させるのに必要なので、当然ながら予想されるものである。タグと属性による選択は、以下の注意点を除いて、おおむね予想どおりに動作する。第一に、タグは互いに関係を持つことができ、あるタグによる選択は他のタグも選択されるべきことを意味する。これは XCSG の実装に使われた。XCSG は種類どうしの関係を規定しており、InstanceMethod のような種類は Method でもある。第二に、選択はノードとエッジのどちらにも関わりうる。ノードを選択するときはすべてのエッジが除外され、エッジを選択するときはすべてのノードが保持される。4.1 で述べたように、これはコールグラフなどの走査を比較的簡単に作れるようにするための意図的なものである。
タグと属性による選択に加えて、XCSG のよく使われる名前付きの実体を選択するための便利な式がいくつかある。たとえば、universe().methods(“foo”) は foo という名前のすべてのメソッドを選択する。これは別の書き方では universe().nodesTaggedWithAny(Method).selectNode(name, “foo”) となる。この場合、式の連鎖は実質的にタグと属性値の共通部分であることに注意する。
4.2.2 集合の式
集合の式には union、intersection、difference がある。Union と intersection は、クエリの式が表すグラフの基盤となるノードの集合とエッジの集合に対する演算と考えることができる。一般に、Q から得られるグラフは、基盤となるグラフの要素への重複した参照を決して含まない。基盤となるグラフはノードの集合とエッジの集合から構成されるからである。
difference の式は、取り除かれたノードに接続するエッジを必然的に除外するという点で特殊である。実際には、difference はクエリの式がノードだけのグラフに対応する場合に使うのが最もよいことが分かっている。ただし、左側の式からエッジだけを取り除くことを指定するための differenceEdges という式がある。
集合の式に加えて、式 a.induce(b) は b から a へエッジを加える。エッジが加えられるのは、a がそのエッジに接続する両方のノードを含むとき、かつそのときに限る。たとえば、与えられたメソッドの間のコールグラフのエッジは methods.induce(edges(Call)) によって誘導できる。
4.2.3 走査の式
原理的には、方向とパスの長さを取る走査の式が一つあれば足りる。実際には、利便性のために多くの式がある。
式 forward は 4.1 で前述した。これは本質的に、与えられたノードから始まり、エッジの方向に沿って到達可能な部分グラフを返す。式 reverse も同様であるが、エッジの方向に逆らって進む。
走査の式は、本質的に、方向と、1 ステップ、n ステップ、無限ステップというパスの長さとの直積である。加えて、between は論理的に forward と reverse の共通部分と等価である。betweenStep の式は、二つの部分グラフの間の直接の関係を見つけるのに役立つ。たとえば、edges(Call).betweenStep(a,b) は a と b のメソッドの間の誘導されたコールグラフを与える。ここでエッジは、1 ステップで a から始まり b で終わらなければならない。
おそらく最もよく使われる走査は Contains エッジに沿ったものである。これらは、クエリの結果に字句上の文脈を与えるのにも、パッケージ、型、またはメソッドの下の部分グラフを選択するのにも使えるからである。クエリが組み合わせられるので、複雑な解析結果に対応する要素を文脈の中に置くのは容易である。任意の部分グラフ x が与えられれば、それを囲む字句上の実体は式 edges(Contains).reverse(x).union(x) で加えられる。
すでに示した構文に加えて、オペランドを入れ替えただけの別の形の走査の式もある。たとえば、コールグラフは x.forwardOn(edges(Call)) とも表現できる。実際には、この形のほうが便利なことがある。通常はまずノードを選択し、その後エッジの部分集合に沿って走査することを考えるからである。この形はノードを先に置くので、ビルダー記法を用いて前の式を続けるのがより自然になる。
ここまでに論じた走査の式はすべて、クエリの結果に起点のノードを含むよう設計されている(その理由は 4.1 に示した)が、これが常に望ましい振る舞いとは限らない。結果に起点のノードを含めると扱いにくくなったり冗長になったりする場面は多い。簡単な例の一つは、型自体を除いた型の直接のメンバーを得る場合である。このため、与えられたノードの直前の先行ノードまたは直後の後続ノードを返す式 predecessors と successors が用意されている。
4.2.4 用途の例
クエリが実際にどのように使われるかを感じてもらうために、短い例をいくつか示す。
第一に、データフローはコールグラフと同様に、リスト 1 のクエリを用いて走査される。これは、与えられた変数から順方向のデータフローグラフを得る方法を示している。
Q dataFlow = edges(DataFlow_Edge).forward(someVariable);リスト 1: データフローのクエリ
第二に、メソッドの完全な制御フローグラフは、リスト 2 のクエリを用いて得られる。このクエリは、まずメソッドの下のすべてに一致させ、制御フローのノードで絞り込み、その後制御フローのエッジを誘導する。
Q body = edges(Contains).forward(someMethod);
Q cfgNodes = body.nodesTaggedWithAny(ControlFlow_Node);
Q cfg = cfgNodes.induce(edges(ControlFlow_Edge));
リスト 2: 制御フローグラフのクエリ
5 事例研究:知能増幅を可能にする
本節では、新しい解析を XCSG に統合し、既存のグラフ表現を活用して、1) 人と機械の協働を促し、2) 他の解析との組み合わせを促すことで、知能増幅という目標を共に実現する方法を示す。
XCSG のグラフ表現の前身は、Android アプリの対話的なプログラム解析のためのツールの構築に使われてきた。特に、事前の記述を拒み、完全に自動的な検出を困難または不可能にする、高度で新しいマルウェアの探索のためである [16]。
その後、XCSG は、Evidence-Enabled Collaborative Verification(EECV)と呼ぶ手法によって、Linux カーネルの重要な安全性とセキュリティの性質の検証を助ける高度な解析手法の開発に使われてきた [25]。この手法は、合計 37MLOC となる 3 つのバージョンの Linux カーネルに適用された。これまでに、この手法は Linux カーネルで確認済みのバグを 8 件発見している。検証をスケールアップするのに用いた手法一式の詳細、特に検証のインスタンスを分割するのに用いた分類の手法は、[19, 26] に示されている。
本節では、EECV 手法の背後にある中核的な概念の一つである射影制御グラフ(Projected Control Graph、PCG)に基づく事例研究を示す。PCG のモデルを示すのは、人と機械の協働にとっての価値のためである。大規模なコードベースを監査する過程では、人の注意をプログラムの重要な側面に集中させることが重要である。それを実現する一つの方法が PCG である。
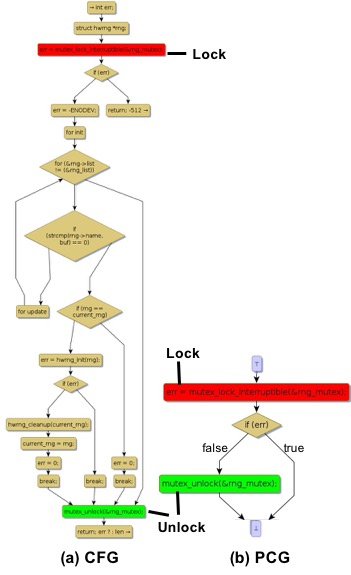
PCG は、問題に固有のプログラムの成果物の集合に関して定義される、制御フローグラフ(CFG)のコンパクトな派生物である。数学的には、抽象代数の準同型の概念を用いて厳密に定義できる。PCG の数学的な詳細については [26] を参照されたい。PCG は、検証における二つの重要な課題、すなわち (a) CFG におけるパスの数の指数的な増大と、(b) パスの実行可能性の検査の指数的な計算量に対処するよう設計されている。PCG は、すべての異なるトレースを保持するのに必要なノードだけを保持するが、それぞれの異なるトレースに対応するパスはただ一つだけである。CFG は非常に多くの異なるパスを持ちうるが、異なるトレースはごく少数しかない。PCG は、トレースごとに一つのパスだけを保持することで、すべてのパスの検証を最適化する。[26] は、CFG を PCG へ、ノードとエッジの数に関して線形時間で変換する効率的なアルゴリズムを示している。図 5 は、ロックとアンロックの事象に対応する、CFG 内の選択された事象に関して両者を比較している。
我々は、PCG を計算するアルゴリズムを XCSG に基づいて実装し、得られたグラフを XCSG のグラフデータベースに具体化した。XCSG に基づく PCG のモデルは制御フローグラフを用いて計算され、関連するプログラムの成果物を指定するために ControlFlow_Nodes を受け取る。プログラムの成果物によるパラメータ化により、PCG を既存の解析と組み合わせられる。他の解析は、関連するプログラムの成果物に至るために任意の計算を行える。あるいは、既存のアフォーダンスを活用し、(第 3 節で述べたように)テキストやノードのユーザーによる選択によって駆動することもでき、ユーザーは任意のプログラムの成果物に基づく PCG を素早く構築できる。これらの機能により、解析の設計者は、ユーザーインターフェースとクエリ言語を用いて興味深い事象の最初の近似を素早く得ることで、解析の新しいアイデアを素早く試作でき、時間をかけて、事象を自動的に計算する強力な解析を開発できる。
PCG の解析を統合する際に XCSG を活用した興味深い方法は、ほかにもある。
第一に、より広い範囲のプログラムの成果物を選択しやすくするために、DataFlow_Node からそれを囲む ControlFlow_Node へたどる小さなコードを加えた。これにより、Assignment のような DataFlow_Nodes に関して PCG を素早く調べられる。クリック一つで、選択したノードがループ内にあるかどうかを素早く判断できる。複数のノードを選択すれば、それらの実行トレースがどのように関係しているかを見られる。
第二に、C で書かれた Linux に適用した PCG は、Java の解析で必要になりうるような例外的な制御フローを考慮する必要がなかった。XCSG が ExceptionalControlFlow_Edges をモデル化する方法のおかげで、PCG が通常の制御フローと例外的な制御フローの両方を入力として受け取る実験を素早く行う機会が得られた。PCG を生成する当初のアルゴリズムを、与えられた任意の部分グラフ上で計算を行うように簡単にパラメータ化でき、例外的な制御フローのエッジを含めるかどうかを容易に切り替えられるようになった。例外的な制御フローのエッジの意味論は、関連するプログラムの文が例外の送出前に実行されたかどうかが分からないという点で、通常の制御フローのエッジとは異なる。そのため、我々の PCG の表現の上に構築される他の解析への影響については、まだ検討を進めているところである。しかし、ほとんどすぐに実験を始められたことは喜ばしかった。
第三に、DataFlow_Nodes の選択のサポートを実装すると、データフローの走査と PCG を掛け合わせたビューを作れることに気づいた。データフローに沿って進む対話的なビューはすでにあり、それ自体が有用である。しかし、これらのデータフローに沿って興味深い事象に出会うことは多く、次の問いは「これらの文のうちどれが最初に実行されるか」になる。この問いにすぐに答えるために、これらのデータフローのノードを手動で選択して、PCG のための関連するプログラムの成果物を定義できる。しかし、このビューが有用だと判断すれば、もう少しの労力で、データフローグラフの走査が示す事象に関して PCG を自動的に射影する新しいビューを作れる。
このようにして、XCSG は、解析の開発者が困難な問題を解くために人との協働のためのアフォーダンスを活用しやすくし、またグラフを通じた組み合わせを可能にしてきた。これらはすべて知能増幅の実現に役立つ。
我々の長期的な研究目標は、XCSG を基盤として、PCG を新しい種類の解析問題に適用することである。
6 実装と性能
性能の感覚をつかんでもらうために、変換の過程と、XCSG そのものを入力として用いる後処理の段階として実行されるアルゴリズムに関する統計を示す。プログラムはまず Jimple に変換され、その後 [1] で入手できる Atlas のバージョン 2.6.1 を用いて XCSG に変換される。実験は、128GB の RAM を搭載し Ubuntu 14.04.3 LTS が動作する 1.8 GHz のクアッドコア Intel Xeon CPU(E5-2603 v2)で行った。
2 つのプログラム、OpenJDK 7u80_b32 と小さな「hello world」プログラムを変換した。結果を表 1 に示す。Call と InterproceduralDataFlow のエッジの保守的な推定を得るために、クラス階層解析(CHA)[9] を用いた。
Jimple のテキストに変換すると、OpenJDK は空行を除いて 420 万行を超える。OpenJDK の変換は完了までに 77 分かかり、メモリ上のグラフ全体を格納するのに 16GB の RAM を要する。OpenJDK 7 の 20,925 個の型が変換された。
対比のために、ほぼ最小の Java プログラムである「hello world」も変換した。このプログラムについては、[4] の SPARK [20] を用いて、このプログラムの実行中にどの OpenJDK API のクラスが読み込まれうるかを保守的に計算し、それらのクラスだけを変換した。これには 2,505 個の型が含まれた。
進行中の実験の一部として、[29] のループ識別アルゴリズムを実装した。これは XCSG の制御フローモデルを解析し、その結果を注釈として付ける。この解析器は OpenJDK に対して 1 分未満で実行される。
| XCSG の種類 | OpenJDK 全体 | HelloWorld + OpenJDK の一部 | |
|---|---|---|---|
| ノード | Method | 171,279 | 21,002 |
| Type | 20,925 | 2,505 | |
| Variable | 408,317 | 44,879 | |
| ControlFlow | 2,676,789 | 297,214 | |
| DataFlow | 7,853,827 | 833,740 | |
| その他 | 101,912 | 12,580 | |
| 合計 | 11,233,049 | 1,211,920 | |
| エッジ | Call | 3,611,359 | 128,172 |
| InterproceduralDataFlow | 11,945,382 | 463,461 | |
| その他 | 32,497,748 | 3,505,174 | |
| 合計 | 48,054,489 | 4,096,807 | |
| 変換時間 | 77 分 | 4 分 | |
| メモリ上のデータベース | 16GB | 2GB | |
7 関連研究
7.1 プログラム解析におけるグラフ
グラフは明らかに XCSG の中心である。プログラムのグラフ表現に関連する研究については、第 2 節ですでに論じた。多くの興味深い解析がすでにグラフに基づいて開発されているので、同じ表現が人と機械の協働を促すことを保証しつつ、解析の組み合わせを可能にする形で、そのような解析を XCSG にどのように統合できるかを探ることに関心がある。
そのような解析の一つを、射影制御グラフ(PCG)[26] に基づいて第 5 節で示した。PCG は、PDG [10] で定義される制御依存のエッジとある程度の関係がある。制御依存のエッジが与えられれば、PCG を構築できるはずである。しかし、制御依存のエッジによるグラフは PCG とは別物であることを急いで付け加えておく。PCG は制御フローグラフ(CFG)からの準同型な写像を用いて導出され、その意味論は CFG を知る者なら誰にでもすぐに馴染みのあるものである。一方、PDG は支配関係の概念を用いて導出される。PCG により、特定のプログラムの成果物の集合に焦点を当てて、本質的な制御フローの振る舞いを捉える、はるかに小さなグラフを作れる。この焦点は重要な側面であり、今後の研究を推進するものとなる。
7.2 プログラム解析におけるグラフクエリ
[27] は、Java プログラムを Neo4J [3] のグラフデータベースに取り込む試作について報告している。彼らは、構造やデータフローを例とするオーバーレイの概念を提唱した。彼らは、多くのクエリが本質的に複数のオーバーレイからの情報を用いることに注目し、Neo4J によるいくつかの例を示した。この試作は、javac の内部から抽象構文木(AST)のノードをほぼそのまま変換することでプログラムを表現している(たとえば、グラフデータベース内のメソッド宣言には、javac の対応する AST ノードの名前「JCMethodDecl」が付けられる)。[27] と比べると、XCSG は PDG や SDG とはるかに多くの共通点を持つ。命令レベルの詳細が制御フローとデータフローの表現によって捉えられるからである。加えて、XCSG は用いる用語体系の統一を目指しており、種類どうしの関係を規定している。
[15] は、大規模な C/C++ プログラムに対してクエリを行うツールを示しており、これも [3] を用いて実装されている。彼らは、現在のモデルで多くのクエリを簡潔に表現できると考えているものの、Neo4J のバージョン 2 以降、ノードのラベルの機能によってノードの種類どうしの関係を表現でき、さらに簡潔にできるだろうと述べている。しかし、Neo4J は現在、エッジに複数のラベルを付けることをサポートしておらず、これは XCSG が活用している機能である。彼らは可能な回避策に言及しているが、「一般に、一致の指定はよくても簡潔さを失い、悪ければ不可能になる」と付け加えている。
[33] は、AST、CFG、PDG を、やはり Neo4J のグラフデータベースで表現することで脆弱性を発見する手法を述べている。彼らは、その手法で Linux カーネルの脆弱性を発見できることを示しているが、検出は静的解析の限界によって制約されると述べている。対照的に、XCSG は、人と機械が目の前の限界を克服できるようにし、プログラム解析の自動化の研究を可能にするよう設計されている。
すべての関連研究の中で、[18] が精神的に最も近いかもしれない。その貢献の一つは、「PDG が、セキュリティ保証の探索、仕様化、強制を可能にする統一的な手法を提供するという新しい洞察」である。探索の側面について、彼らは、プログラムにあらかじめ定義されたセキュリティポリシーがなく、アプリケーションに固有のポリシーを発見する必要がある場合に、これが役立つと述べている。多くの困難なプログラム検証の問題では、そのような探索が必要になると考えており、これは XCSG に対する我々の手法に大きな影響を与えている。彼らはまた、PidginQL というドメイン固有言語(DSL)を持っている。記述された PidginQL の文法は、第 4 節で述べた Q クエリ言語に非常によく似ている。大きな違いの一つは、Q が埋め込み DSL として実装されており、Java のコードとの統合が比較的シームレスであることである。彼らが述べるユーザー定義関数の一部は Java で実装されており、グラフにアクセスするための便利な手段として Q を用いている。
8 結論
我々は、プログラム全体と関連する解析の、人に優しいグラフベースの表現である eXtensible Common Software Graph を示した。XCSG は、数百万行のプログラムにおける困難な検証問題に取り組むための人と機械の協働を可能にするよう設計されている。これは、プログラムの意味論の完全な表現を含めることだけでなく、より重要なこととして、ノードとその関係の両方の同値類について慎重に選択し、解析の層を融合してより高度なクエリを可能にすることによって実現されている。プログラムのモデルとの人の対話の容易さと簡潔さに直接影響し、より効率的な人と機械の協働を可能にするのは、これらの同値類である。
結局のところ、困難な問題に今取り組むため、そして将来、検証を自動化または半自動化する創造的な解決策を生み出すのに役立てるために、人と機械の協働を可能にしなければならない。我々は、Linux カーネルにおける重要な安全性とセキュリティの性質を検証するのに用いた基盤となる解析に基づく事例研究を示し、新しい解析を XCSG にどのように融合し、それによって人との協働のための既存のアフォーダンスを活用し、他の解析との組み合わせを可能にできるかを例示した。新しい解析が XCSG に融合されるにつれて、それらは、人がこれまで予期されなかった方法で解析を組み合わせる能力をさらに高め、それによって人と機械の協働を通じて知能を増幅する。XCSG の成熟は、実践者なしには不可能であった。DARPA APAC プログラムの期間中に XCSG とその多くの草案を使ってくれた、Iowa State University の多くのポスドク、大学院生、学部生、そして EnSoft の同僚、また DARPA STAC プログラムのもとで引き続き使ってくれている人々に感謝したい。特に、XCSG を改善するための多くの詳細な提案と、それを活用した創造的な方法について、Tom Deering と Ben Holland に感謝したい。また、本論文の準備を支援してくれた Nikhil Ranade と Kevin Korslund にも感謝したい。
参考文献
- Atlas Website.
- DOOP: Framework for Java Pointer Analysis.
- Neo4j Graph Database.
- Soot - A Java optimization framework.
- XCSG - Extensible Common Software Graph.
- F. E. Allen. Program optimization. Annual Review in Automatic Programming, 5, 1969.
- S. Arzt, S. Rasthofer, C. Fritz, E. Bodden, A. Bartel, J. Klein, Y. Le Traon, D. Octeau, and P. McDaniel. FlowDroid: Precise context, flow, field, object-sensitive and lifecycle-aware taint analysis for Android apps. In Proceedings of the 35th ACM SIGPLAN Conference on Programming Language Design and Implementation, PLDI ’14, pages 259–269, New York, NY, USA, 2014. ACM.
- F. P. Brooks Jr. The computer scientist as toolsmith II. Communications of the ACM, 39(3):61–68, 1996.
- J. Dean, D. Grove, and C. Chambers. Optimization of object-oriented programs using static class hierarchy analysis. In Proceedings of the 9th European Conference on Object-Oriented Programming, ECOOP ’95, pages 77–101, London, UK, UK, 1995. Springer-Verlag.
- J. Ferrante, K. J. Ottenstein, and J. D. Warren. The program dependence graph and its use in optimization. ACM Transactions on Programming Languages and Systems (TOPLAS), 9(3):319–349, 1987.
- M. Fowler. Domain-specific languages. Pearson Education, 2010.
- S. Freeman and N. Pryce. Evolving an embedded domain-specific language in Java. In Companion to the 21st ACM SIGPLAN Symposium on Object-oriented Programming Systems, Languages, and Applications, OOPSLA ’06, pages 855–865, New York, NY, USA, 2006. ACM.
- M. I. Gordon, D. Kim, J. Perkins, L. Gilham, N. Nguyen, and M. Rinard. Information-flow analysis of Android applications in DroidSafe. In Proc. of the Network and Distributed System Security Symposium (NDSS). The Internet Society, 2015.
- C. Hammer and G. Snelting. Flow-sensitive, context-sensitive, and object-sensitive information flow control based on program dependence graphs. Int. J. Inf. Secur., 8(6):399–422, Oct. 2009.
- N. Hawes, B. Barham, and C. Cifuentes. Frappé: Querying the Linux kernel dependency graph! In Proceedings of the GRADES’15, page 4. ACM, 2015.
- B. Holland, T. Deering, S. Kothari, J. Mathews, and N. Ranade. Security toolbox for detecting novel and sophisticated Android malware. In Proceedings of the 37th International Conference on Software Engineering - Volume 2, ICSE ’15, pages 733–736, Piscataway, NJ, USA, 2015. IEEE Press.
- S. Horwitz, T. Reps, and D. Binkley. Interprocedural slicing using dependence graphs. In Proceedings of the ACM SIGPLAN 1988 Conference on Programming Language Design and Implementation, PLDI ’88, pages 35–46, New York, NY, USA, 1988. ACM.
- A. Johnson, L. Waye, S. Moore, and S. Chong. Exploring and enforcing security guarantees via program dependence graphs. In Proceedings of the 36th ACM SIGPLAN Conference on Programming Language Design and Implementation, PLDI 2015, pages 291–302, New York, NY, USA, 2015. ACM.
- S. Kothari, P. Awadhutkar, A. Tamrawi, and J. Mathews. Modeling lessons from verifying large software systems for safety and security. In 2017 Winter Simulation Conference (WSC), pages 1431–1442. IEEE, 2017.
- O. Lhoták. Spark: A flexible points-to analysis framework for Java. 2002.
- O. Lhoták and L. Hendren. Evaluating the benefits of context-sensitive points-to analysis using a bdd-based implementation. ACM Trans. Softw. Eng. Methodol., 18(1):3:1–3:53, Oct. 2008.
- K. J. Ottenstein and L. M. Ottenstein. The program dependence graph in a software development environment. In Proceedings of the First ACM SIGSOFT/SIGPLAN Software Engineering Symposium on Practical Software Development Environments, SDE 1, pages 177–184, New York, NY, USA, 1984. ACM.
- Y. Smaragdakis, M. Bravenboer, and O. Lhoták. Pick your contexts well: Understanding object-sensitivity. SIGPLAN Not., 46(1):17–30, Jan. 2011.
- Y. Smaragdakis, G. Kastrinis, and G. Balatsouras. Introspective analysis: Context-sensitivity, across the board. In Proceedings of the 35th ACM SIGPLAN Conference on Programming Language Design and Implementation, PLDI ’14, pages 485–495, New York, NY, USA, 2014. ACM.
- A. Tamrawi and S. Kothari. Evidence-enabled collaborative verification of software for safety and cybersecurity. Submitted to IEEE International Conference on Software Testing, Verification and Validation (ICST 2016).
- A. Tamrawi and S. Kothari. Projected control graph for computing relevant program behaviors. Science of Computer Programming, 163:93–114, 2018.
- R.-G. Urma and A. Mycroft. Source-code queries with graph databases—with application to programming language usage and evolution. Science of Computer Programming, 97:127–134, 2015.
- R. C. Waters. A method for analyzing loop programs. IEEE Trans. Softw. Eng., 5(3):237–247, May 1979.
- T. Wei, J. Mao, W. Zou, and Y. Chen. A new algorithm for identifying loops in decompilation. In H. Nielson and G. Filé, editors, Static Analysis, volume 4634 of Lecture Notes in Computer Science, pages 170–183. Springer Berlin Heidelberg, 2007.
- M. Weiser. Program slicing. In Proceedings of the 5th International Conference on Software Engineering, ICSE ’81, pages 439–449, Piscataway, NJ, USA, 1981. IEEE Press.
- M. Weiser. Programmers use slices when debugging. Commun. ACM, 25(7):446–452, July 1982.
- P. T. Wood. Query languages for graph databases. SIGMOD Rec., 41(1):50–60, Apr. 2012.
- F. Yamaguchi, N. Golde, D. Arp, and K. Rieck. Modeling and discovering vulnerabilities with code property graphs. In Proceedings of the 2014 IEEE Symposium on Security and Privacy, SP ’14, pages 590–604, Washington, DC, USA, 2014. IEEE Computer Society.