
1. 背景
我々の目標は、ソフトウェア工学を、現在の手作業中心で非常に労働集約的な形から、高度に自動化されながらも人間が方向付ける形へと変えることである。我々は、自動化を実装することでエンジニアを退屈な作業から解放し、それによって人が本当に重要で刺激的なこと、すなわち人間の洞察と創造性に集中できるようにすることを目指す。
| ものを作る | |||
|---|---|---|---|
| 紀元前 1,650,000 年 | 紀元前 30,000 年 | 紀元前 2500 年 | 現在 |
| ? | |||
| 1950 年代 | 1972 年 | 現在 | 未来 |
| ソフトウェアを作る | |||
人間の創意工夫は、パンチカードの時代から我々を遠くまで運んできた。そして今日、我々はソフトウェアを書く能力を大きく効率化する Eclipse のようなツールを高く評価している。しかし、次の飛躍をどう成し遂げるのか。ソフトウェアの大量生産へとどう早送りするのか。すでにそこに到達していると言う人もいるが、我々はそうは考えない。旅は始まったばかりである。現在、膨大な量のソフトウェアが存在するが、それらはエジプト人がピラミッドを石を一つずつ積んで築いたのと同じ、骨の折れるやり方で作られている。エジプト人は、そのような巨大な構造物を可能にする適切な技術を備えていたが、我々と同様に、築ける規模は純粋な人間の労働によって制限されていた。
未来を初めて垣間見たのは 2000 年、ParAgent を作ったときであった。ParAgent は、50 万行の気象モデリングコードを単一プロセッサからクラスタ型スーパーコンピュータへ移植する過程を大幅に高速化したツールである。作業の手作業の部分を減らすことで、元々 3 人年を要した作業が、わずか 2 週間で一人によって再現された。75 倍を超える高速化である [1]。
ParAgent は単発の成功としてではなく、ソフトウェア自動化の将来の可能性を実現する旅の第一歩として見るべきである。我々は自問した。この成果からどのような原理を学べるか。他のどのような分野にこれを適用できるか。これらは、Iowa State University の Knowledge-Centric Software Laboratory で我々が答えようと取り組んできた問いである。
本論文では、Linux カーネルに関する我々の研究を、ソフトウェア工学の変革を目指すユニークな探検として紹介する。我々の旅は、Linux カーネルのビザンチンバグを追跡しようとする一人のエンジニアから始まり、次に Linux カーネルにおける同期の検証という野心的な目標へと進む。どちらの物語も、遠くない未来に我々がソフトウェアにどのように取り組みうるかについて、単純でありながら深い洞察を与える。
2. Linux カーネルのビザンチンバグの追跡
我々の旅は、大手ネットワーク機器メーカーのエンジニアである Srinivas Neginhal から始まる。彼は、ネットワークスタックのコードを通り、ポインタの参照外しを越え、スレッドの間をまたいで、Linux カーネルのビザンチンバグを追跡しようとしていた。これはまさに困難な仕事である。Srinivas はバグの追跡に慣れていたが、ほとんどのバグは機器が顧客に配備された後に初めて発見されるため、彼の苛立ちは絶えなかった。ビザンチンという言葉は、これらのバグを特徴付ける複雑な相互作用、すなわち容易に再現できず、解きほぐすのが難しい相互作用を表すため、最も適切な用語である。
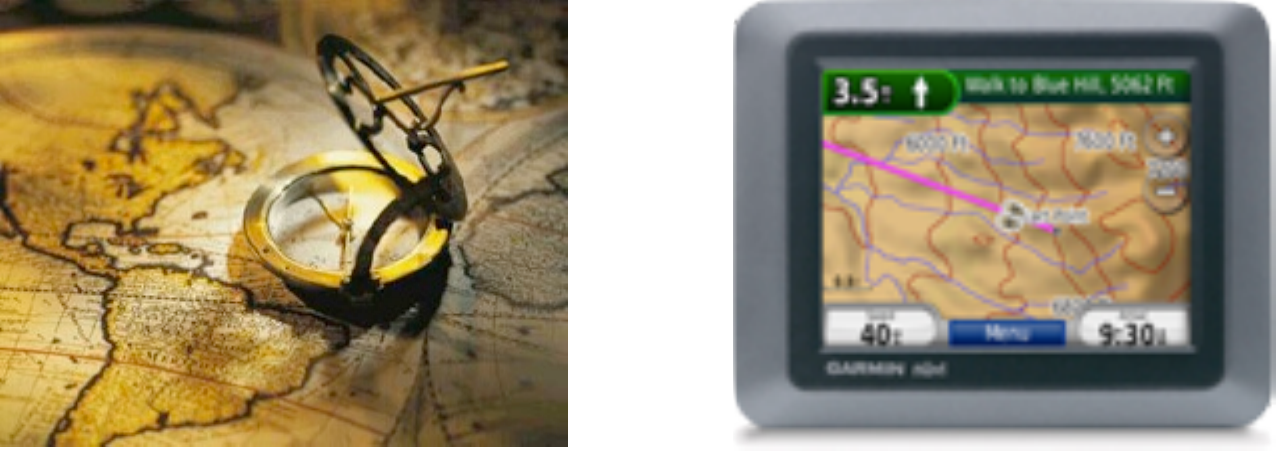
これらのバグを追跡するもっと効率的な方法があると確信した Srinivas は、従来の方法論への不満を動機として、よりよい方法を見つけようとした。彼は、コンパスと地図だけを持った熟練の航海士のように、コードを一度に一つのパスずつたどっていると感じていた。彼が切実に求めていたのは GPS、すなわち多くの経路を一度に検討する方法であった。最初のステップは、これらのバグが手作業でどのように追跡されているかを理解し、次に自動化によってその過程を高速化しようとすることであった。
その過程を示すため、Srinivas は Intel PRO/1000 ギガビットイーサネットドライバを通るパケットの軌跡を追跡することにした。Linux カーネルでは、このドライバは e1000 と名付けられ、21,032 行のコードの中に 284 個の関数を含む。コード内でパケットを追跡することは、主にコードを書くことではなく読むことであると、すぐに明らかになった。これは、その過程を高速化するには、書くことではなく、コードを読むことを自動化する必要があることを意味した。
Arthur と Pigoski によれば、ソフトウェアの保守にかかる時間の最大 90% は、ソフトウェアを読む(すなわち理解する)ことに費やされる [2, 3]。ピラミッドを築くことを想像してほしい。最初の石は容易に動かして土台を形作れるが、高さが増すにつれて、重い石を築きつつある構造物の頂上まで持ち上げることに、ますます多くの時間と労力がかかる。同様に、大規模で成熟したソフトウェアシステムでは、コードを読むことにますます多くの時間が必要になる。
e1000 ドライバの一端から他端までパケットを追跡することは、ニューヨークからロサンゼルスまで旅することのように考えられる。ニューヨークとロサンゼルスの間のあらゆる経路を記憶することはできないが、地理の一般的な知識によって、根拠のある予測ができる。ニューヨークからロサンゼルスへの経路は存在するはずであり、おそらく東西に走る高速道路のある地図を思い浮かべるであろう。しかし、あらゆる経路を思い描くことはとてもできない。同様に、我々がコードを読む過程は、メンタルモデルに導かれ、我々の脳が扱える限られた情報量によって制約される。まず、ネットワークドライバがどのように動作するかのメンタルモデルで記憶を新たにしよう。
1. ネットワークドライバのメンタルモデル
通常、ネットワークデバイスはパケットを受信するとプロセッサに割り込みをかける。デバイスの割り込みハンドラはパケットを受け取り、受信キューに入れる。その後、別の実行スレッドで、カーネルがパケットをキューから取り出して処理する。パケットの種類に基づいて、カーネルはパケットを適切なプロトコルハンドラへ振り向ける。関数ポインタによって実現される実行時の束縛は、プロトコルスタックの効率的でモジュール化された実装を可能にする。[4]
2. e1000 ドライバが受信パケットを処理する仕組み
このメンタルモデルは、284 個の候補のうちどの関数が目の前の作業に関係するかを判断する手引きとなる。メンタルモデルから、まずパケットがネットワークから受信される場所を探すことから始めればよく、その場所はおそらく割り込みであることがわかる。命名規則から e1000_intr() が e1000 ドライバの割り込みハンドラであると推測できるので、そこから始める。e1000_intr() を見ると、__netif_rx_schedule() を呼び出していることがわかる。__netif_rx_schedule() は、net device 構造体を softnet_data データ構造内の CPU ごとのポーリングリストに入れ、NET_RX_SOFTIRQ softirq の実行をスケジュールする。これで我々はメンタルモデルの第 2 段階にいる。
次のステップは、パケットがポーリングリストから取り出されて処理される場所を見つけることである。具体的には、softnet_data データ構造のメンバ変数 poll_list がリスト操作関数に渡されるコードを探す。しばらく探して読むと、これは関数ポインタ dev->poll を呼び出す net_rx_action() で起きていることがわかる。dev->poll がどの関数を指すかを突き止めなければならない。e1000_probe() が dev->poll を e1000_clean() に初期化していることがわかる。
e1000_clean() は e1000_clean_rx_irq_ps() を呼び出す。これは、rx ring と呼ばれるバッファで待っていたパケットを取り出し、sk_buff オブジェクトを構築する。これがメンタルモデルの第 3 段階である。これらの sk_buff オブジェクトは netif_receive_skb() に渡され、そこからネットワークスタックのさらなる層へ送られる。
3. 半自動的なコード読解への対話的手法
コードを読み進めながら、我々は手がかりをつなぎ合わせ、それらの手がかりとメンタルモデルを用いてコードについて問いを立てる。そして、それらの問いに答えるためにさらに読む。Srinivas は Suraj Kothari と協力して、この過程の一部を自動化する CVision を作った。CVision は対話的なツールであり、ユーザーは、コードの関係する部分に素早く到達し、プログラム要素間の関係をグラフィカルに可視化し、さまざまなグラフ縮約を対話的に適用して無関係な関係を取り除くことができる [4]。いくつかの例を見てみよう。
1. 例 1
メンタルモデルから、e1000_intr() は後で処理するためにパケットをキューに入れなければならないことがわかっている。Linux カーネルを扱ったことがあれば、キューやその他のリストが list.h で宣言された関数によって操作されることも知っているであろう。「e1000_intr() は list.h で宣言された関数とどのような関係を持つか」と問うことができたらどうだろう。下のグラフがその答えである。
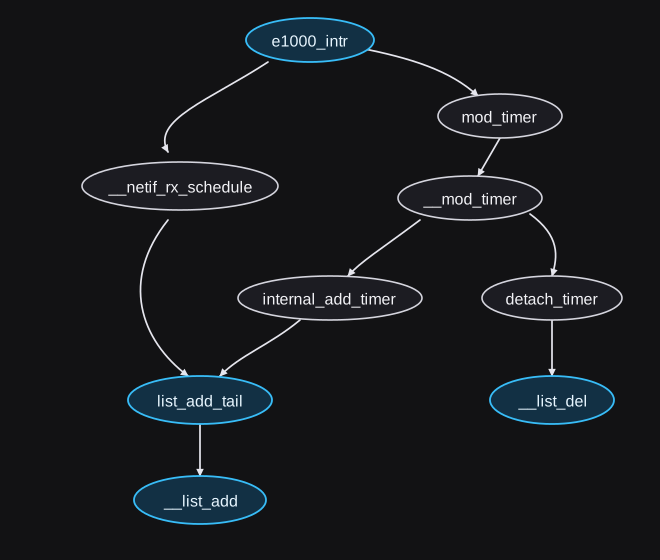
mod_timer() は、名前からパケットの移動に関与していないことがうかがえるため疑わしい。関数を手早く調べると、そのことが確認できる。mod_timer から到達する関係を除外することで、答えを絞り込める。
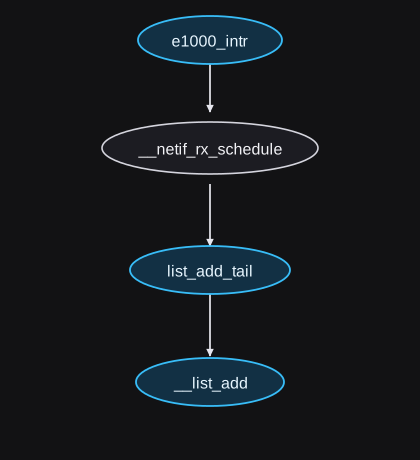
mod_timer() を除いた、e1000_intr() と list.h の関数との呼び出し関係。e1000_intr() と list.h の関数は青で示す。これは、__netif_rx_schedule() をもっと詳しく見るべきであることを強く示唆している。
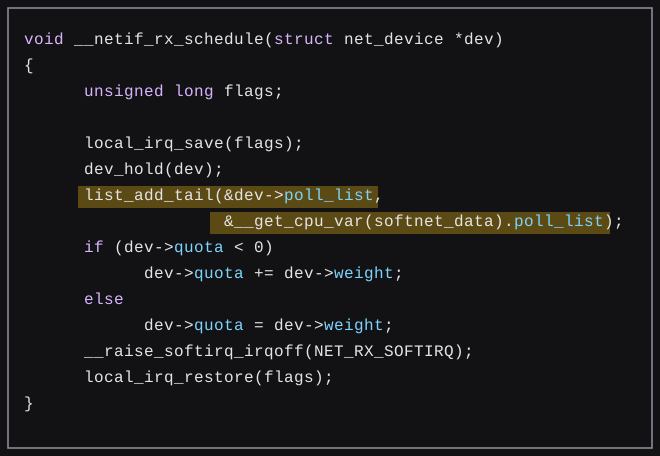
__netif_rx_schedule() のリスト予想どおり、強調表示されたテキストで、デバイスの poll_list が softnet_data.poll_list に追加されていることがわかる。e1000 ドライバの完全な解説は [4] の 5.2 節に詳述されている。
2. 例 2
前の例では、関心のある関係は互いに非常に近くにあった。今度はネットワーキングの外で、関係が遠く離れており予想外でありうる、Linux カーネルの別の例を見てみよう。
kmalloc() による動的なメモリ割り当ては、ファイルシステムと何か関係があるだろうか。少し考えてみてほしい。現代のオペレーティングシステムに関する自身のドメイン知識から、答えを推測できるはずである。
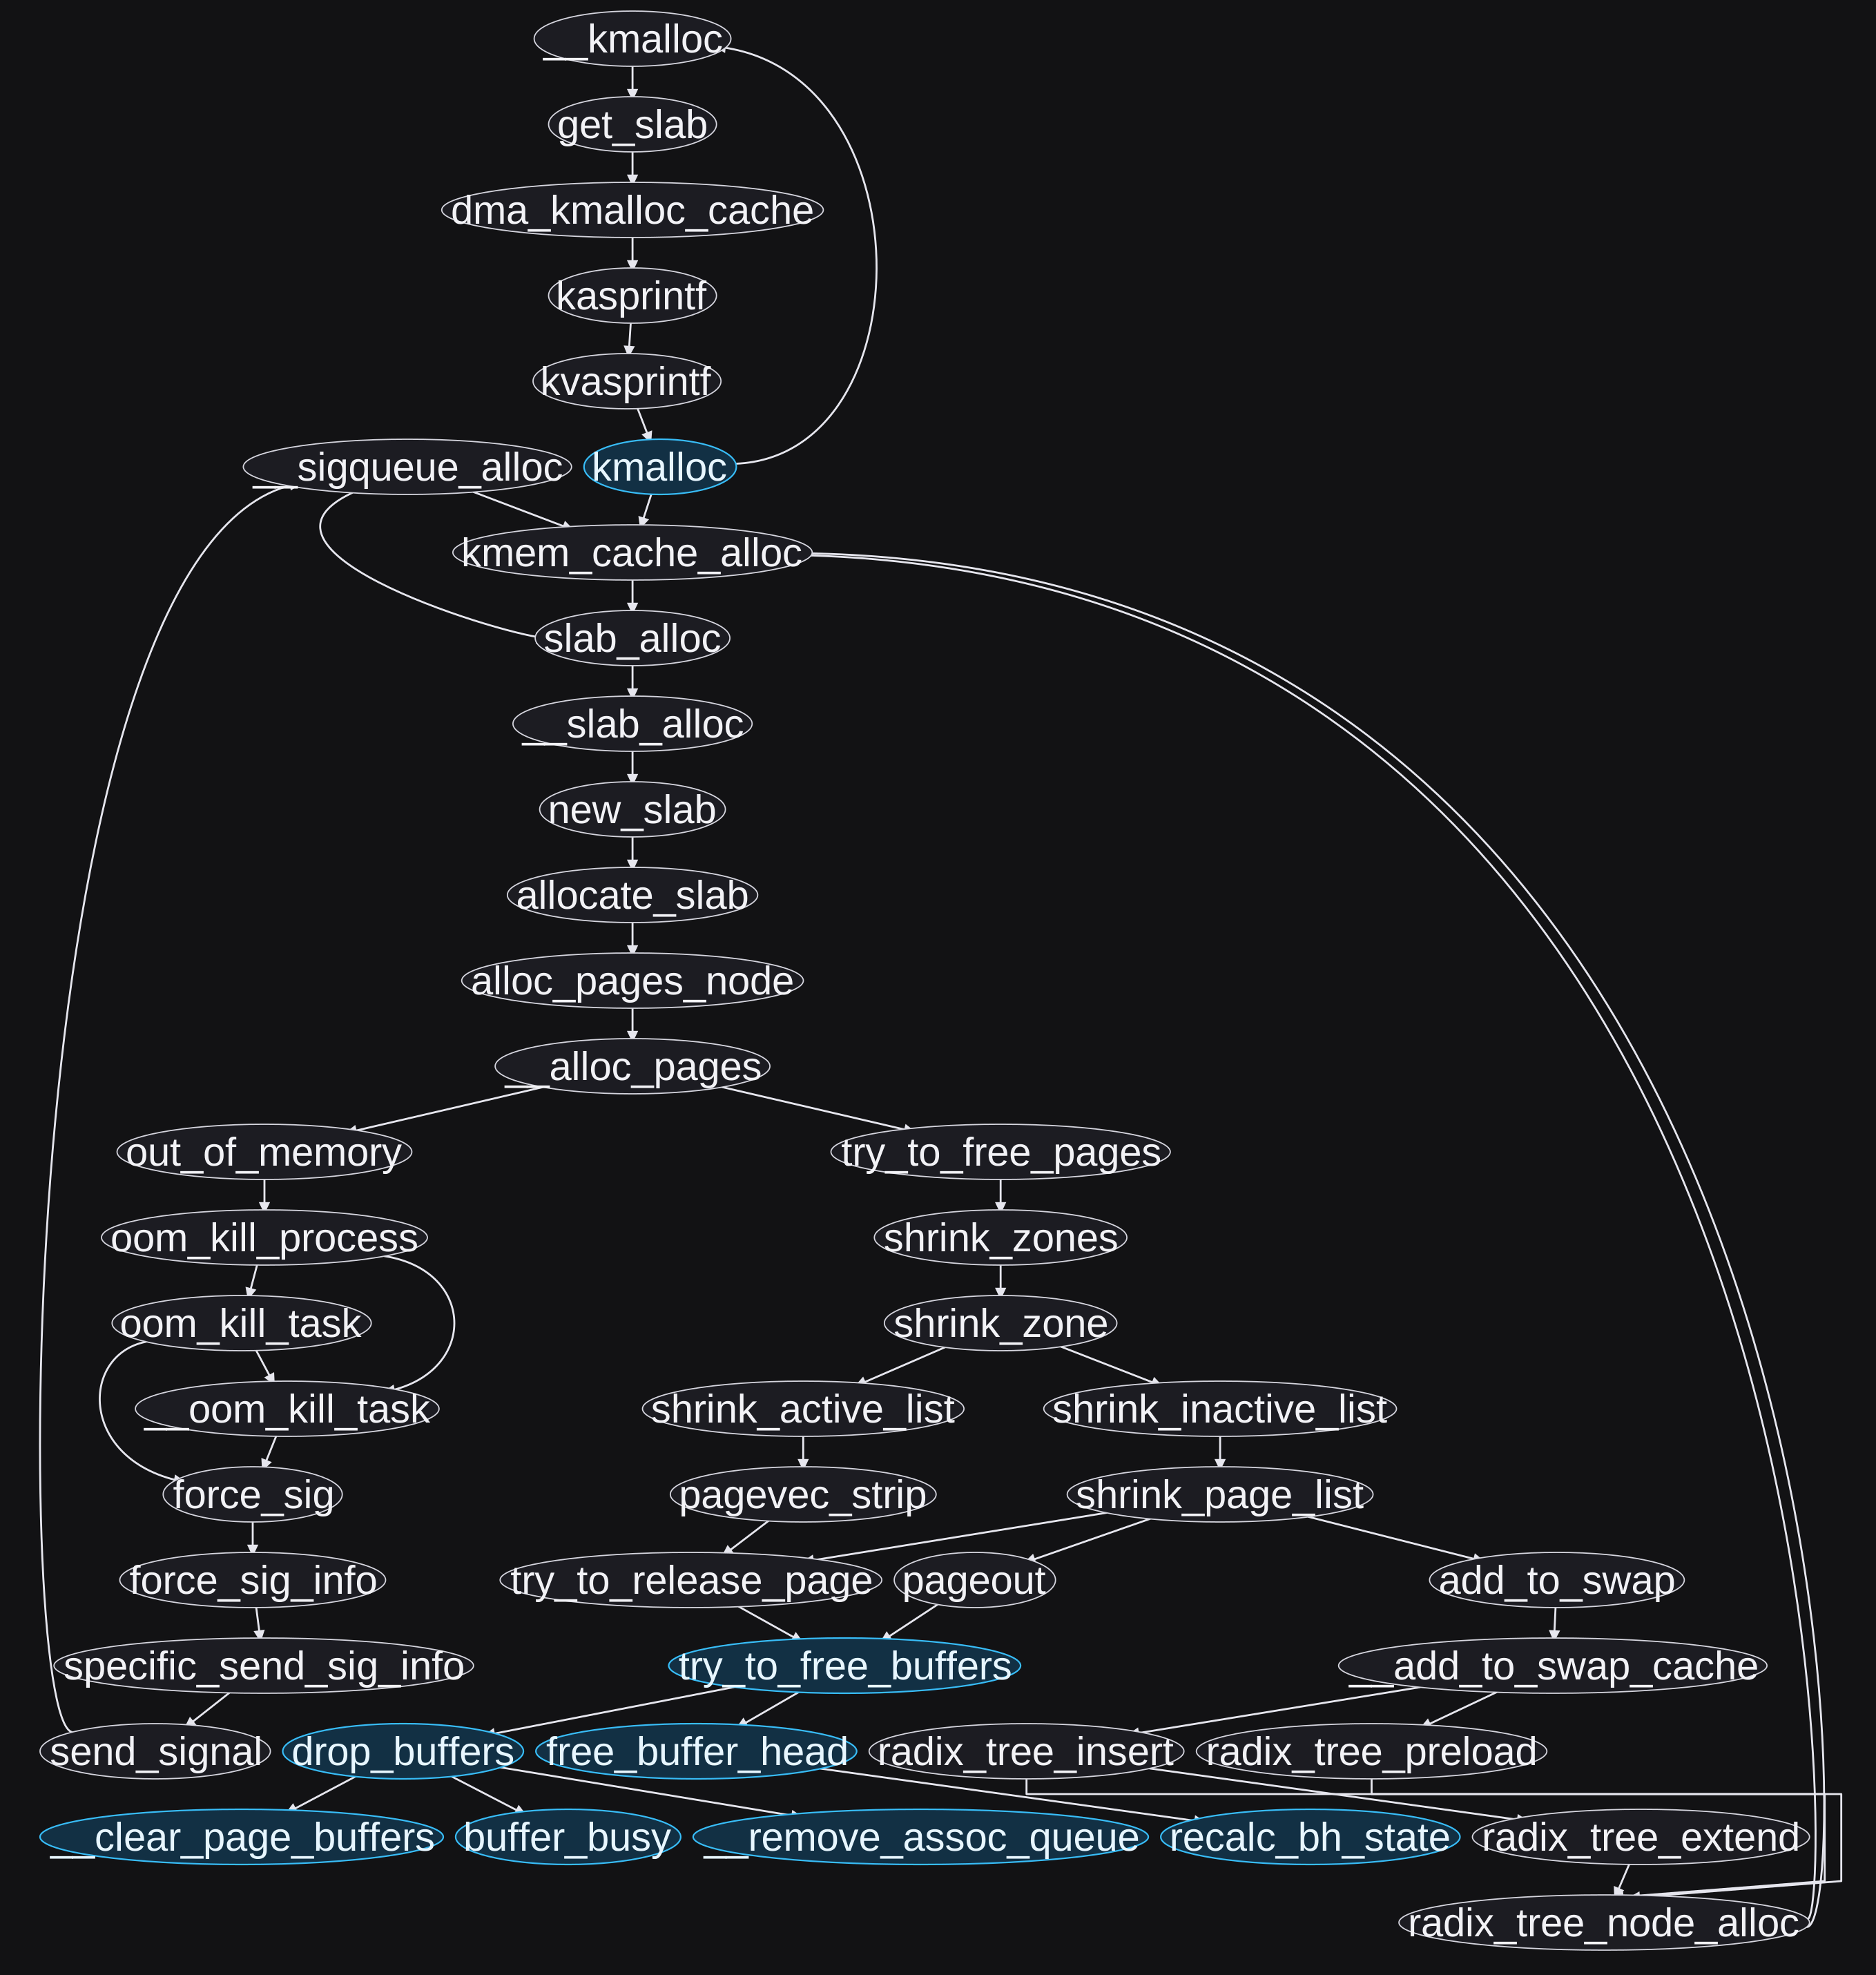
kmalloc() とファイルシステムとの呼び出し関係答えは「Yes!」である。利用可能な物理メモリがないとき、カーネルは仮想メモリを使わなければならず、それはファイルに置かれていることがある。図 6 では、kmalloc() と、それがファイルシステム内で到達できる関数が強調表示されている。
3. Linux カーネルにおける同期の検証
2 節では、e1000 ドライバ内のコードを、ドライバを通るパケットの軌跡を理解するのに必要な関数とデータ構造だけに絞り込む方法を探った。我々は反復的な手法をとり、ツールは、関数とその関係についてユーザーが問いを立てられるようにすることで、コードの読解を高速化した。この節では、Srinivas とともに開発した手法を応用して、Linux カーネルを丸ごとふるいにかけ、興味深いソフトウェアの成果物をまとめて見つけ出す試みを探る。
科学の他の分野では、道具の手作業による使用から、大量のデータの自動処理と調査へと進むことはありふれている。1609 年に Galileo Galilei が望遠鏡を空に向けて以来、その後の 2 世紀にわたって天文学者は観測を手で描き留めた。しかし、1840 年に John William Draper が月の写真を撮ると、それは天文学的発見の新しい時代を促し、1958 年には Palomar Observatory Sky Survey が完了して、約 2000 枚の写真乾板を用いて北天全体が撮影された [hc17, hc21]。
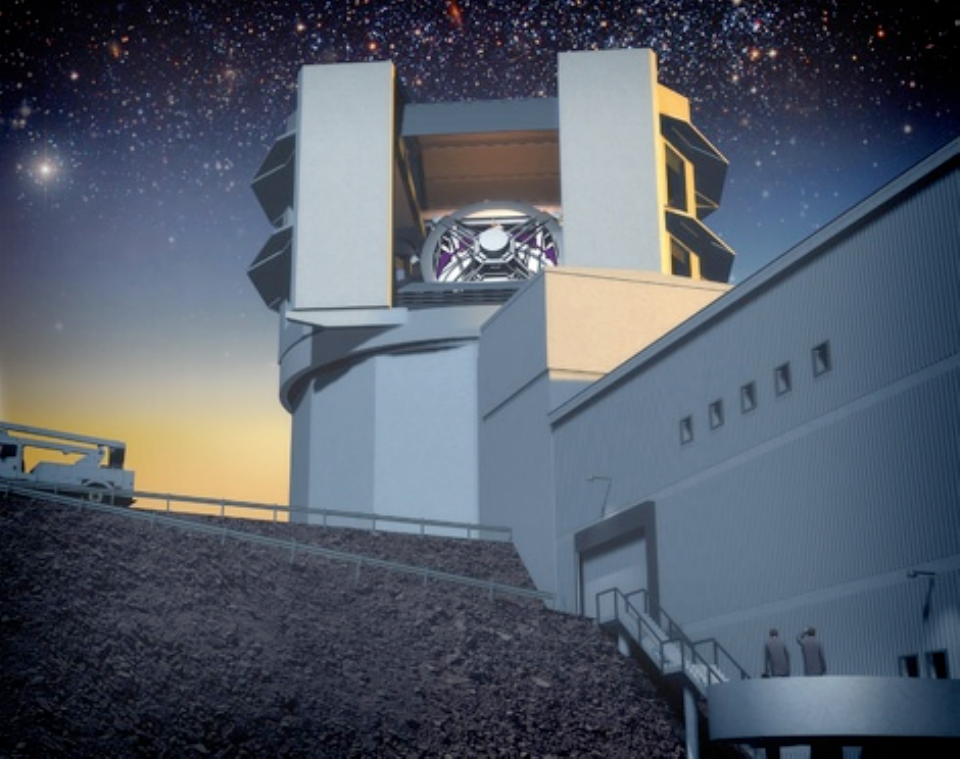
現在、Large Synoptic Survey Telescope の設計が進められている。2015 年に運用を開始する予定で、3.2 ギガピクセルのカメラを用いて毎週夜空全体を撮影する [16]。このプロジェクトは 60 ペタバイトのデータを生成し、興味深い恒星のイベントを特定するには、それをコンピュータでふるいにかけなければならない [17]。Large Synoptic Survey Telescope と同様に、我々の手法は、ソースコードの興味深い部分をエンジニアの注意の前に差し出すことである。エンジニアは自らの洞察と他のツールや手法を用いて、それらをより詳しく調べる。
我々は、調査する最初の興味深いソフトウェアの成果物としてマッチングペア性質を選んだ。具体的には、Linux カーネルにおける mutex_lock()1 と mutex_unlock() の使用が正しいことを検証したかった。以下の節では、マッチングペア性質の形式的な定義を示し、Linux カーネル(バージョン 2.6.31)の膨大な 1,081,090 行のコードと 39,973 個の関数をふるいにかける我々の手法を述べる。
1 mutex_trylock() と mutex_lock_interruptible() もロックの獲得に用いられることがあり、これらも考慮した。説明を簡潔にするため、本文では mutex_lock() と mutex_unlock() に焦点を当てる。
ただし、同期の場合、我々の野心的な目標は、現場で起きる前にバグを見つけることである。
1. 同期とマッチングペア性質
Linux カーネルにおける同期は、マッチングペア性質の特殊な場合である [6]。マッチングペア性質の例には次のものがある。
- 同期: ロックとアンロック
- ファイルアクセス: オープンとクローズ
- メモリ管理: 割り当てと解放
すべてのマッチングペア性質に共通するのは、トークンのインスタンスに作用する二つの「反対の」イベントである。我々は MP 性質の次の一般的な定式化を用いる。任意の実行パスにおいて、P(X) の呼び出しが用いる識別子は、ちょうど一つの V(X) の呼び出しに流れ込み、そこで用いられなければならない。ここで P と V はソフトウェアにおける問題固有のイベントであり、X はそれらが共有するトークンである。表 2 に P、V、X の二つの例を示す。
| 問題 | P | V | X |
|---|---|---|---|
| メモリリーク | kmalloc() | kfree() | メモリへのポインタ |
| 誤った同期 | mutex_lock() | mutex_unlock() | ミューテックスへのポインタ |
Linux カーネルにおける同期は、あるミューテックスに対する mutex_lock() と mutex_unlock() の呼び出しを対応させることで実現される。
図 8 には、マッチングペア性質が次第に複雑になる四つのコールグラフが示されている。
(a) P(X) と V(X) が同じ関数 a1 の中で呼び出される単純な例。
(b) b1 と P(X) および V(X) の間に中間の関数がある、より複雑な場合。
(c) ある実行によって、P(X) と V(X) がコードを通る異なる自明でないパスから呼び出されることがある。
(d) 通常、制御フローは制御構造と呼び出しの系列を通じて目に見える。しかし、この例では P(X) と V(X) の対応する呼び出しが異なるスレッドで行われる。
図 8(b,c,d) の例は、マッチングペア性質の正しい振る舞いを検証するには、P(X) と V(X) を呼び出す関数を調べるだけでは十分でないことを示している。これらの関数が他の関数を介して互いにどのように関係しているかを理解することも重要である。例えば図 8(b) では、b2 で P(X) によって獲得されたトークンを、b3 での V(X) による解放に結び付けるために b1 が必要である。ある関心事や振る舞いがコードの異なる部分に分散しているとき、我々はそれを横断的と呼ぶ [12]。
2. 過去の取り組み
我々の目標は、同期のバグを起きる前に見つけるために、Linux カーネルにおける mutex_lock() と mutex_unlock() の使用が正しいことを検証することである。バグを起きる前に見つけることは決して新しくはないが、この問題に対するコンピュータのみの手法には深刻な限界がある。
多くのツール [7, 8, 9, 10, 11] は高速な手続き内の静的解析を行える。しかし、文脈依存の静的解析による解法のアルゴリズム計算量は指数的に増大するため [13, 14]、マッチングペア性質の横断的なインスタンスの大規模な手続き間解析には適さない。詳細な議論は [5] の 2 節にある。
3. 我々の手法
では、Linux カーネルほど大きなソフトウェアにおいて、同期やその他の同様の横断的な側面の振る舞いをどのように検証するのか。Large Synoptic Survey Telescope に取り組む天文学者は、空にあるすべてのものに関心があるわけではない。むしろ、コンピュータを用いて関心のある天体イベントの部分集合を特定する。同様に、同期やその他の横断的な振る舞いを検証するには、コードのごく一部だけを調べればよい。しかし、3.1 節で述べたように、mutex_lock() と mutex_unlock() を呼び出す関数だけに焦点を当てるのでは十分でなく、それらを接続する関数も調べる必要がある。
Srinivas と同様に、我々は目の前の問題にコードのどの部分が関係するかを特定したい。しかし、バグごとに人間がツールを対話的に使う代わりに、コードをまとめて大幅に絞り込みたかった。その結果は、マッチングペア性質の各インスタンスに関係するコードであるべきである。そうすれば、個々の星団を見る天文学者のように、人間の洞察と他の手法を用いて、コードの関係する部分集合を理解できる。
天文学者は天を理解するために数学を用いる。我々もソフトウェアを理解するために数学を用いる。具体的には、グラフを用いて、コードを選り分ける式とアルゴリズムを作る。ここで示す特定の式は MPG(X) と呼ばれ、以下で述べる [5]。数学の他の産物と同様に、MPG(X) は幅広く適用できる。Linux カーネルにおける同期だけでなく、さまざまなソフトウェアの任意のマッチングペア性質に適用できる。以下の節では、MPG(X) をより詳しく述べ、これまでの結果を提示する。
4. トークン X のマッチングペアグラフ
MPG(X) は、マッチングペア性質のインスタンスを検証するために調べなければならない関数の集合である [5]。Linux カーネルにおける同期の場合、P(X) は mutex_lock() に、P(V) は mutex_unlock() に対応し、X はミューテックスへのポインタである。
以下の四つの基準は、MPG(X) をよく直観的に理解させてくれる(形式的な定義は [5] にある)。あるトークン X について、次のいずれかが真であれば、関数は MPG(X) に含まれる。
- 関数から P(X) または V(X) の一方のみに到達でき、P(X) と V(X) の両方には到達できない場合、その関数は MPG(X) に含まれる。この関数を不均衡であるという。
- 一つ以上の不均衡な関数を直接呼び出す関数。
- 関数が P(X) と V(X) の両方を直接呼び出す場合。
- MPG(X) の要素である関数 a と b について、a がコールグラフを通じて b に到達する場合。a から b へのパス上の関数も MPG(X) に含まれる。
関数から P(X) と V(X) の両方に到達できるとき、その関数を均衡であるという。均衡な関数のすべてが MPG(X) の一部であるわけではないが、この考えには後で触れる。
例えば図 10(v) では、v1 と v2 はそれぞれ P(X) と V(X) の一方のみを呼び出し、両方は呼び出さないので MPG(X) の一部である。v1 と v2 は不均衡であるという。v3 は不均衡な v1 と v2 を呼び出すので MPG(X) の一部である。最後に、v3 は不均衡ではないので、v4 は MPG(X) の一部ではない。
5. MPG(X) は必要か、十分か
MPG(X) は、マッチングペア性質のインスタンスを検証するために調べなければならない関数のみを含む。当然、「この関数の集合は必要か、それとも十分か」という問いが生じる。P(X) によって獲得されたトークン X が最終的に V(X) によってどのように解放されるかを調べなければならないので、MPG(X) は常に必要である。MPG(X) の関数は、これら二つのイベントを結び付ける制御パスを含む。
しかし、実際にたどられるパスは、MPG(X) の関数の外で設定された値に基づく条件に影響されることがある。ただし、すべての条件がマッチングペア性質の特定のインスタンスに影響するわけではない。例えば、リストのソートに関する条件は、そのリストのロックに影響しないはずである。課題は、影響するパスを効率よく調べることである。[5] の 4 節は、調べるべきパスの数を最小化する方法を述べ、それらのパスを提示する、調べやすい表の形式を提案している。
簡潔さと焦点のため、この方法はここでは詳述しないが、同じ精神に従う。すなわち、読解を自動化し、人間の注意をできる限り具体的な情報に集中させることである。
4. 結果と次のステップ
実験は Linux カーネルのバージョン 2.6.31 で行った。我々がビルドしたカーネルは 1,081,090 行のコードと 39,973 個の関数を含む。現在までに、以下に詳述するように、mutex_lock() と mutex_unlock() の MPG(X) を計算した。あるミューテックス X の MPG(X) は、一連の Atlas クエリとして計算される。MPG(X) の形式的な定義と、それを Atlas で計算するアルゴリズムは [5] にある。
1. 詳細な結果
我々は、グローバル変数にあるミューテックスと、ポインタを介して参照される構造体にあるミューテックスについて MPG(X) を計算した。これらの構造体にあるミューテックスについては、ある型の構造体からのミューテックスへのアクセスをすべて同じミューテックスとして扱った。関数または関数の集合は、通常、一度に構造体の一つのインスタンスに対して呼び出されるので、この単純化はほとんどの場合にうまくいく。
mutex_lock() と mutex_unlock() の使用をグローバル変数と構造体の型で分割すると、計算すべき MPG(X) は 249 個になる。表 3 に、計算した MPG(X) のサイズの分布をまとめる。MPG(X) のサイズは大部分の場合で小さく、その 75% 近くで 5 未満である。サイズが 50 を超えるのは 3 例だけである。
| MPG(X) のサイズの範囲 | ≤5 | 6 → 10 | 11 → 50 | > 50 | 平均 |
|---|---|---|---|---|---|
| この範囲の MPG(X) の数 | 186 | 35 | 25 | 3 | 8.24 |
さらに、各 MPG(X) の構造は単純な傾向にある。例えば図 11 の MPG(block_device.bd_mutex) は非常に浅く、ほとんどの関数は図 11 の単純な場合 (a) と同様である。
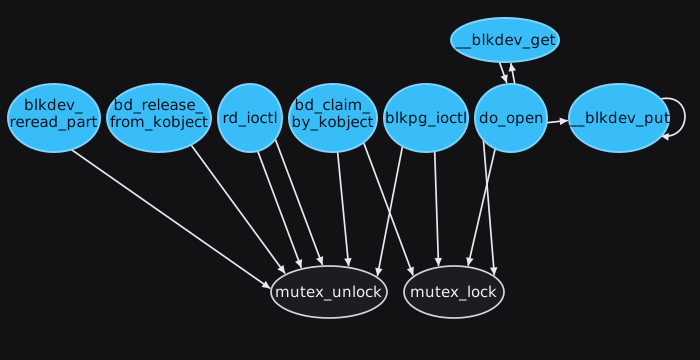
これまでの我々のプロセスは、Linux カーネルにおける mutex_lock() と mutex_unlock() の使用を検証するためにレビューが必要なコードの量を劇的に削減した。また、この作業をごく容易に並列化できるようにした。各 MPG(X) は、何か重要な情報を見落とす心配なしに、他とは独立にレビューできる。
2. 次のステップ
最も重要な次のステップは、mutex_lock() と mutex_unlock() の各 MPG(X) を検証することである。この作業には [5] の 4 節の方法を用いる。
最初の検証の後は、MPG(X) を用いて賢く増分検証を行う計画である。例えば、最初のパスで、どのミューテックスの MPG(X) が変わっていないかを自動的に確認できる。それらのコードも変わっていなければ、再び検証する必要はない。
同様の検証は、Linux カーネルにおけるメモリリークについても行える。この場合、P(X)、V(X)、X は kmalloc()、kfree()、メモリへのポインタである。
実際に調べる必要があるコードの部分集合を中心に指標を作れるので、MPG(X) は検証作業量の正確な見積もりにも使える。
5. おわりに
ニューヨークからロサンゼルスへ向かうにせよ、宇宙の写真を撮るにせよ、ソフトウェアのコードを保守するにせよ、大規模なデータの解釈は人間の頭脳にとって絶え間ない苦闘である。本稿では、コードを書くことよりも読むことに焦点を当てる新しいソフトウェア解析の方法論を初めて垣間見せた。コードのグラフ表現を用いて、コードの読み方を機械で繰り返せるプロセスとして体系化することは、ソフトウェア工学の作業を大幅に高速化する強力な手法である。さらに、ソフトウェア工学の作業のための一般的な式とアルゴリズムを作れることを示した。それらは、かつてない規模でのソフトウェア工学の作業の自動化への道を開く。
我々は、信頼できるコードがどこにでもあり、エンジニアが時間とエネルギーと集中力を革新に使える未来を信じている。この未来へは今日から歩み始められる。コードに取り組むときは、自らに問うてください。
- 書くことよりも読むことにどれだけの時間を費やしているか。
- コードを読むとき、どのような関係を探しているか。
- ある種類の問題に対して同様の手法をとっているか。
- その手法を体系化し、この種のあらゆる問題に適用できるか。
これらは我々の旅から浮かび上がった問いである。これらの問いへの答えが今後の発展への道を開くと我々は考える。皆様の答えをぜひお聞かせください。ご意見は Jeremias Sauceda まで pi@ensoftcorp.com にお寄せください。
謝辞
Linux カーネルに関する取り組みについて Srinivas Neginhal と Kang Gui に感謝する。また、4 節の結果の計算に用いたツール Atlas に関する取り組みについて、EnSoft Corp. の Jon Mathews に感謝する。
参考文献
- Mitra, S., Kothari, S.C., Cho, J., Krishnaswarmy, A.: ParAgent: A domain-specific semi-automatic parallelization tool. In: Proceedings of the 7th International Conference on High Performance Computing. Volume 1970 of Lecture Notes In Computer Science. (2000) 141–148.
- L. J. Arthur. Software Evolution - The Software Maintenance Challenge. John Wiley & Sons, 1998.
- T. Pigoski. Practical Software Maintenance: Best Practices for Managing your Software Investment. Wiley Computer Publishing, 1996.
- S. Neginhal and S. Kothari, “Event views and graph reductions for understanding system level C code,” in ICSM ʼ06: Proceedings of the 22nd IEEE International Conference on Software Maintenance, 2006, pp. 279–288.
- Kang Gui; Kothari, S.; , “A 2-Phase Method for Validation of Matching Pair Property with Case Studies of Operating Systems,” Software Reliability Engineering (ISSRE), 2010 IEEE 21st International Symposium on , vol., no., pp.151-160, 1-4 Nov. 2010.
- S. Cherem, L. Princehouse, and R. Rugina, “Practical memory leak detection using guarded value-flow analysis,” SIGPLAN Not., vol. 42, no. 6, pp. 480–491, 2007.
- “Klocwork k7,” http://www.klocwork.com/.
- “Coverity prevent,” http://www.coverity.com/products/coverity-prevent.html.
- D. Engler, B. Chelf, A. Chou, and S. Hallem, “Checking system rules using system-specific, programmer-written compiler extensions,” in OSDIʼ00: Proceedings of the 4th conference on Symposium on Operating System Design & Implementation, 2000, pp. 1–1.
- D. Evans and D. Larochelle, “Improving security using extensible lightweight static analysis,” Software, IEEE, vol. 19, no. 1, pp. 42–51, Jan/Feb 2002.
- N. Volanschi, “A portable compiler-integrated approach to permanent checking,” in ASE ʼ06: Proceedings of the 21st IEEE/ACM International Conference on Automated Software Engineering, 2006, pp. 103–112.
- M. Eaddy, T. Zimmermann, K. D. Sherwood, V. Garg, G. C. Murphy, N. Nagappan, and A. V. Aho, “Do crosscutting concerns cause defects?” IEEE Trans. Softw. Eng., vol. 34, no. 4, pp. 497–515, 2008.
- M. S. Lam, J. Whaley, V. B. Livshits, M. C. Martin, D. Avots, M. Carbin, and C. Unkel, “Context-sensitive program analysis as database queries,” in PODS ʼ05: Proceedings of the twenty-fourth ACM SIGMOD-SIGACT-SIGART symposium on Principles of database systems, 2005, pp. 1–12.
- R. N. Taylor, “Complexity of analyzing the synchronization structure of concurrent programs,” Acta Informatica, vol. 19, no. 1, pp. 57–84, 1983.
- “Hubblecast 17 Special: New views of the skies,” European Southern Observatory Education and Public Outreach Department, http://www.spacetelescope.org/videos/hubblecast17a/.
- “Hubblecast 21 Special: From silver to silicon,” European Southern Observatory Education and Public Outreach Department, http://www.spacetelescope.org/videos/hubblecast21a/.
- “LSST and Technology Innovation,” http://www.lsst.org/lsst/about/technology.